跳到主要内容

IP 地址自动核查,避免分配冲突

· 阅读需 8 分钟

“这个地址现在没在线,能给新服务器用吗?”

新设备上线前,负责地址发放的陈工停在这一步。表格里没有使用人,候选地址当前也没有在线迹象,但他还不能确认:原设备已经退役,还是临时关机后仍要恢复?

他需要给部署同事一个明确答复。若直接分配,旧设备恢复时可能重复使用;若重新翻资产、查聊天记录、逐个找人,又会把上线前的准备拖长。

以这次简化的分配场景为例,地址自动核查要改善的,正是这段确认工作:将登记、资产与子网内的状态线索放到一起,让运维更快找到判断依据,并提前处理可发现的占用或冲突问题。
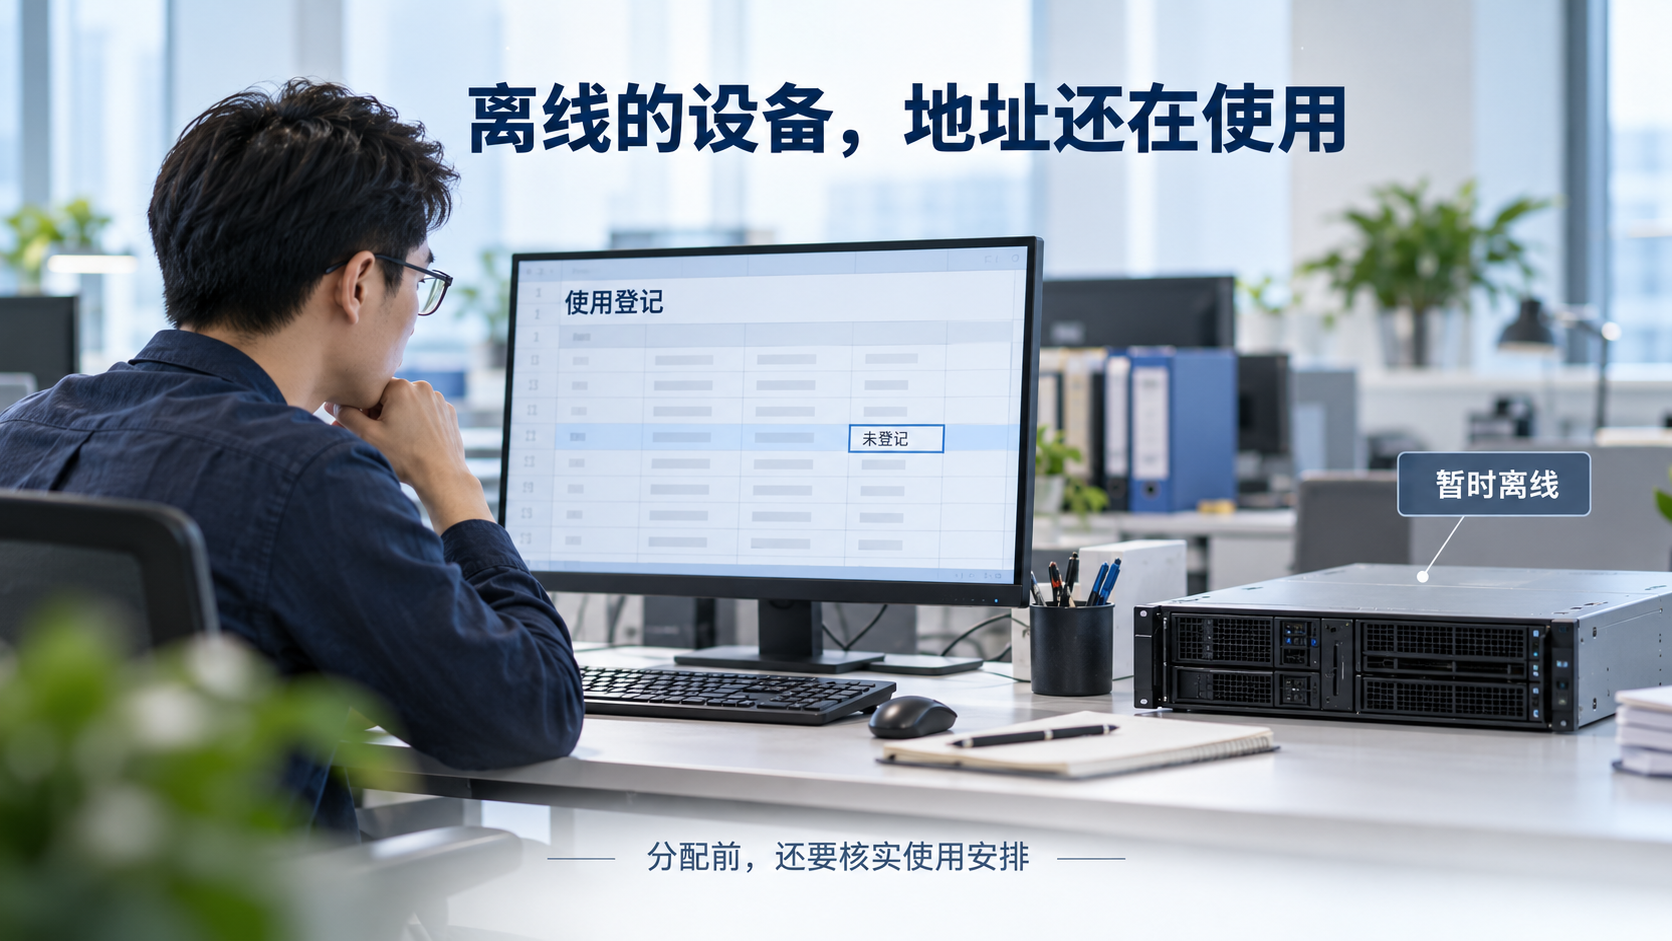
运维分配地址前,需要确认离线设备是否仍保留原有使用安排

防火墙日志结构化,让异常访问查得快、告警配得准

· 阅读需 9 分钟

“这个来源访问新服务,到底有没有被防火墙拦住?”

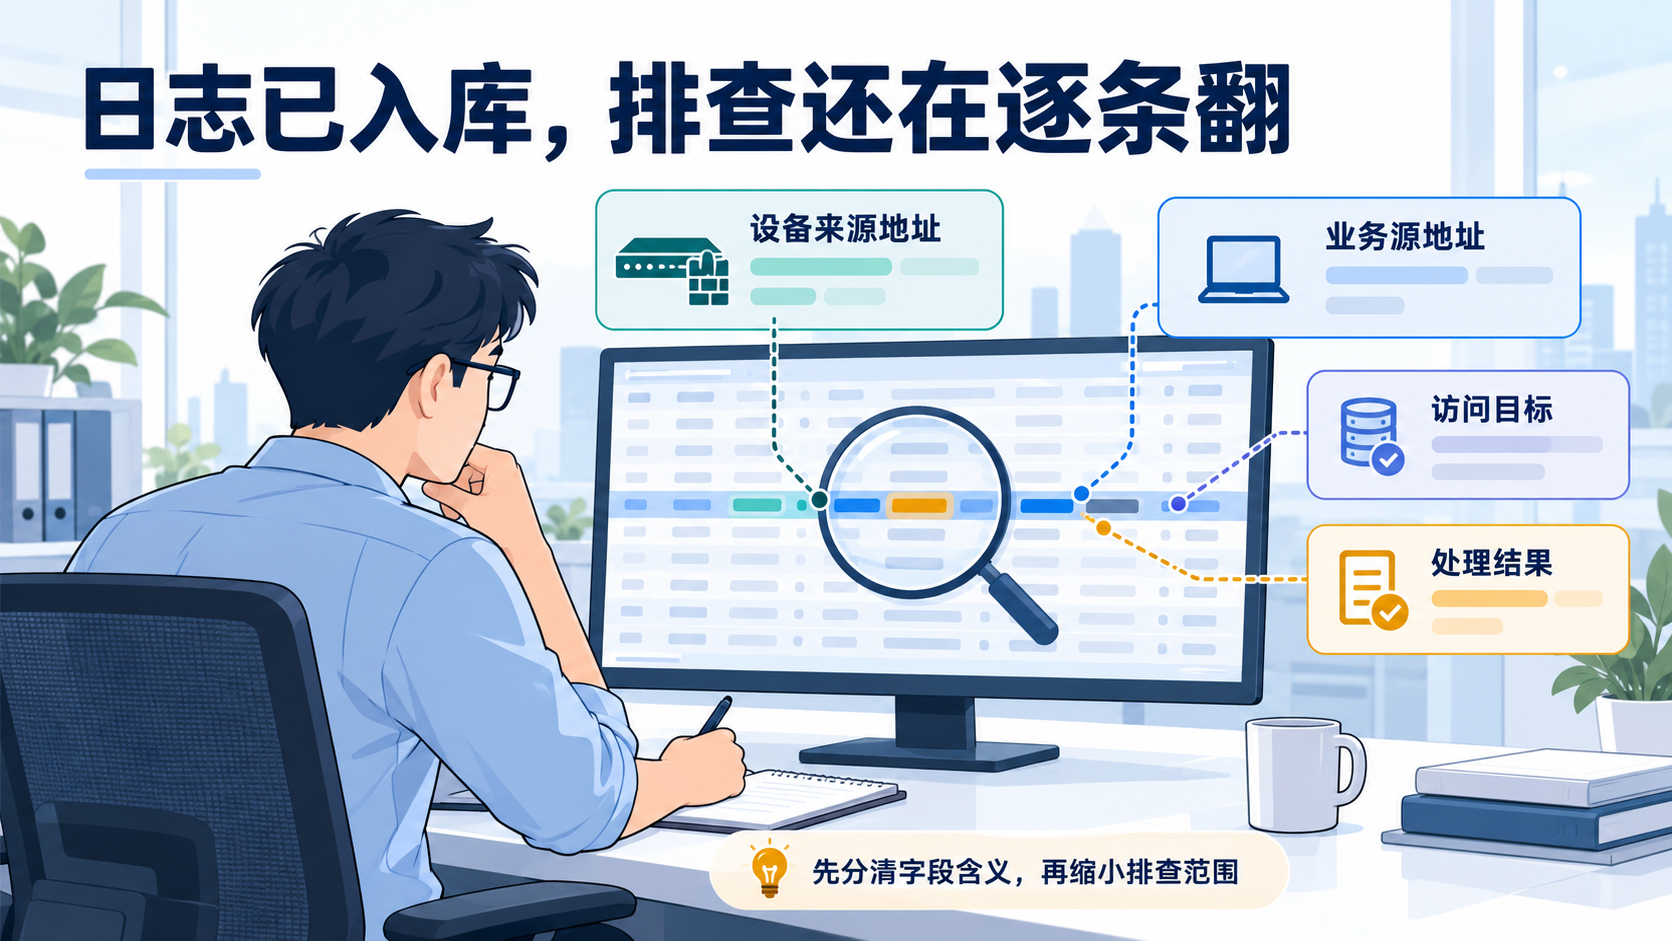
业务发布后,网络运维陈工要核查的是这样一个问题:过去半小时,来源地址 198.51.100.23 访问服务 192.0.2.80 的 443 端口,是否出现了拒绝记录。

他已经把防火墙日志集中收进了检索平台。输入来源 IP,能够搜出结果;但要回答业务,还得逐条看这个地址出现在哪个位置、连接指向哪里、处理结果是什么。换一位同事接手,这些辨认工作往往要再做一遍。

防火墙日志结构化能改善的,正是这段重复劳动:把原始消息里的访问关系提取成字段,让查询直接表达业务问题,并让同一套条件继续用于告警。

下面沿着这次核查,看看这件事怎样落地。地址和日志均为简化示例。

运维核查防火墙日志时,需要从原始消息中辨认访问对象和处理结果

运维人员调岗后,运维平台权限如何快速调整

· 阅读需 8 分钟

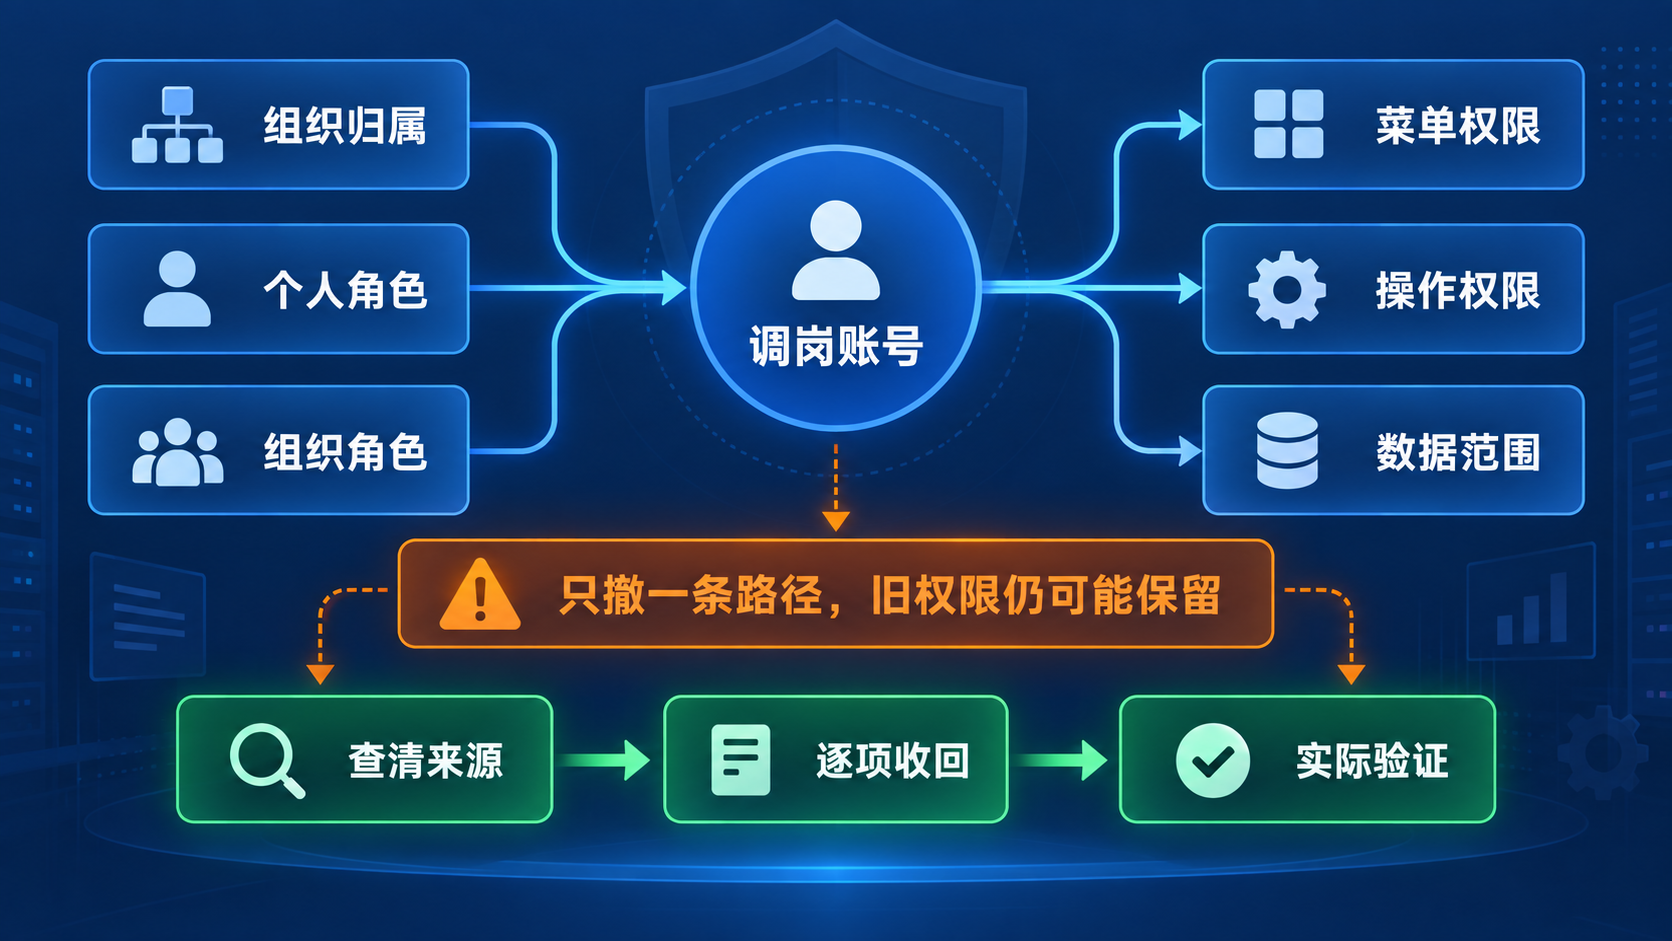
小周从支付保障组调到会员平台组后的第一天,账号很快就加入了新组织,新团队的资产和告警也能正常查看。

但他打开资产列表时发现,原支付团队的服务器仍然在;点进告警中心,原团队正在处理的告警也照常可以打开。

从工作交接的角度看,小周已经离开原岗位;从系统的角度看,他却同时拥有两支团队的访问能力。调岗流程完成了,权限边界没有跟着变化。

运维人员调岗后仍能看到原团队资产与告警

定时任务运行异常,运维人员如何才能及时感知

· 阅读需 8 分钟

晨会前二十分钟,运维负责人小杨收到业务接口人的消息:昨天的日报没有更新。

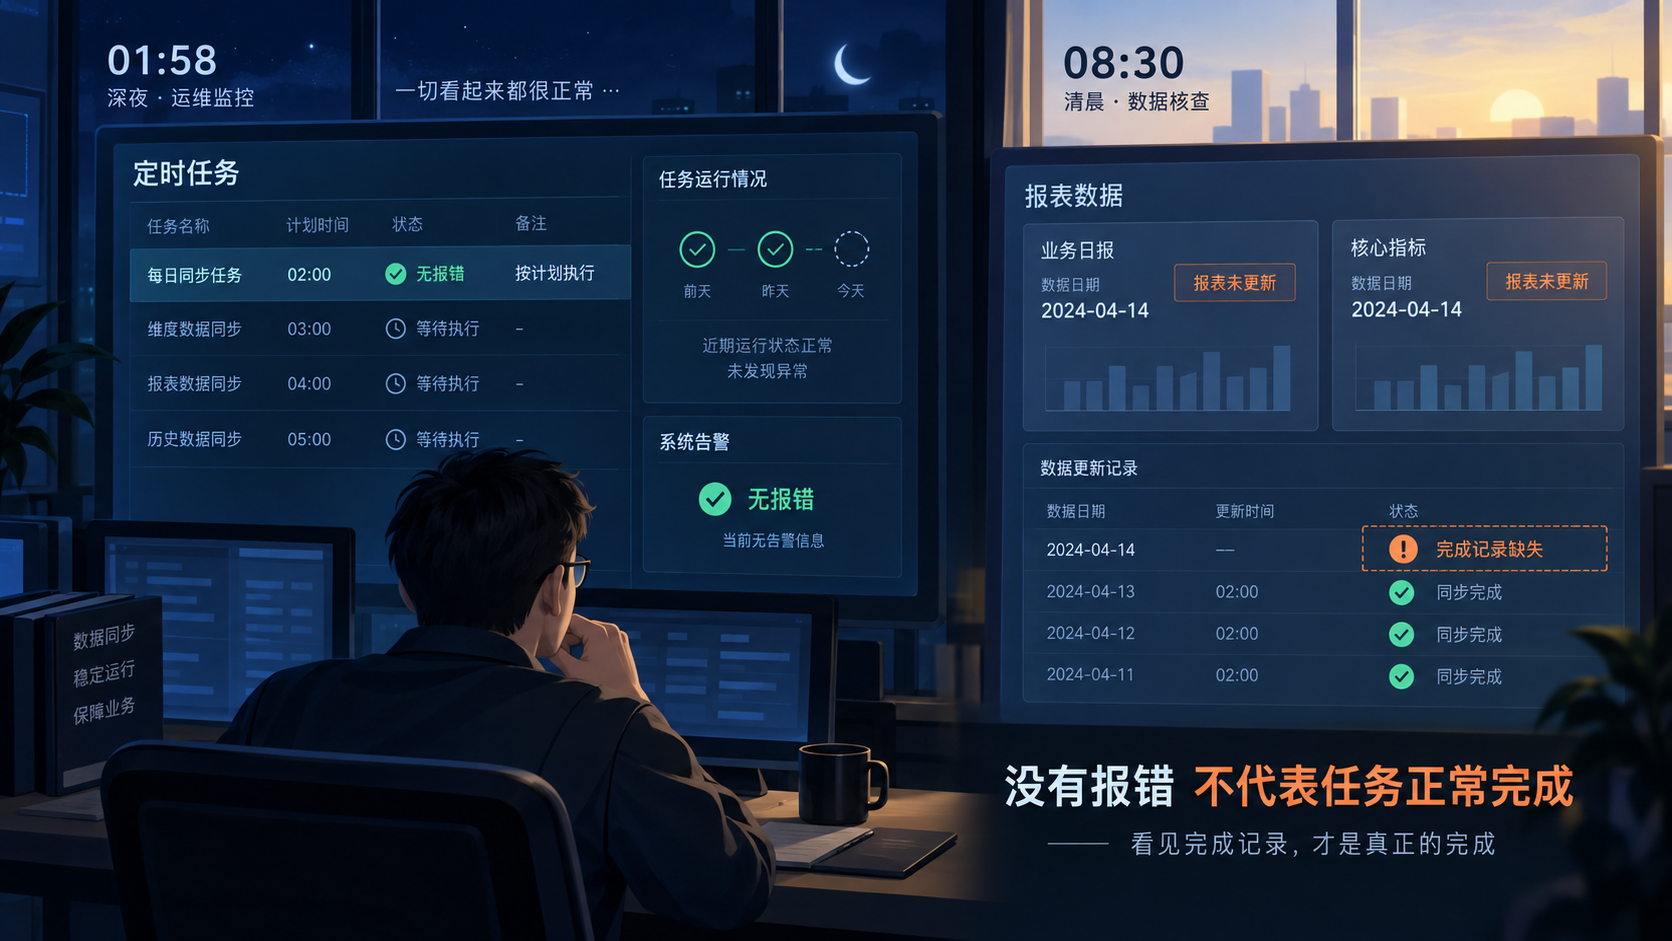
他先看监控。凌晨的日终同步没有错误数上升,主机 CPU 没有尖峰,告警列表也没有新记录。再打开任务执行记录,问题才露出来:这条本应在凌晨完成的同步,没有留下“同步完成”的那条事件。

现场最容易出现的误判是:没有报警,就先假定任务只是晚一点。

但报表已经停在昨天。对业务来说,任务是否抛出异常并不是最终答案;它有没有在约定时间交付应有的结果,才是。

深夜同步未报错但清晨报表没有更新的运维场景

服务没宕机,慢请求已经在吞掉用户耐心

· 阅读需 7 分钟

发布完成后的第十分钟,支付确认页没有报错。

发布负责人小周盯着大盘:实例都在,接口成功返回,错误率也没有抬头。业务接口人却在群里转来客服消息:“页面一直转圈,用户点了两次还是没结果。”

小周先看了可用性,依然是绿的;再看平均时延,也没有离谱。要不要回滚?当下的证据还不足以支持这个动作。

但用户已经在等。这个现场最麻烦的地方就在于,表面上的“服务可用”与用户实际感受到的“操作顺畅”,并不是一件事。

发布后服务仍显示可用,但尾部时延与用户等待已经出现风险

一台核心资产被改了,为什么总要等事故发生才有人知道

· 阅读需 8 分钟

月末结算前二十分钟,小周收到一条支付回调超时的工单。

他先按资产台账里的责任人联系服务组,得到的回复是:“这个组件上周已经转给另一个组了。”他再去查网关地址,看到的还是迁移前的旧 IP;沿着依赖关系往下追,关联也在前几天被调整过。

页面里并不缺信息。责任人变更、地址更新和关系调整都留了记录。可在这场故障真正发生之前,值班和服务负责人都没有看到这些变化。

小周手里拿着一份已经更新的台账,却仍在按昨天的事实排障。

运维人员在控制台前核对资产关系和责任通知

RAG 知识库越积越多,答案为什么越容易“打架”?

· 阅读需 8 分钟

晨会前的两个答案​

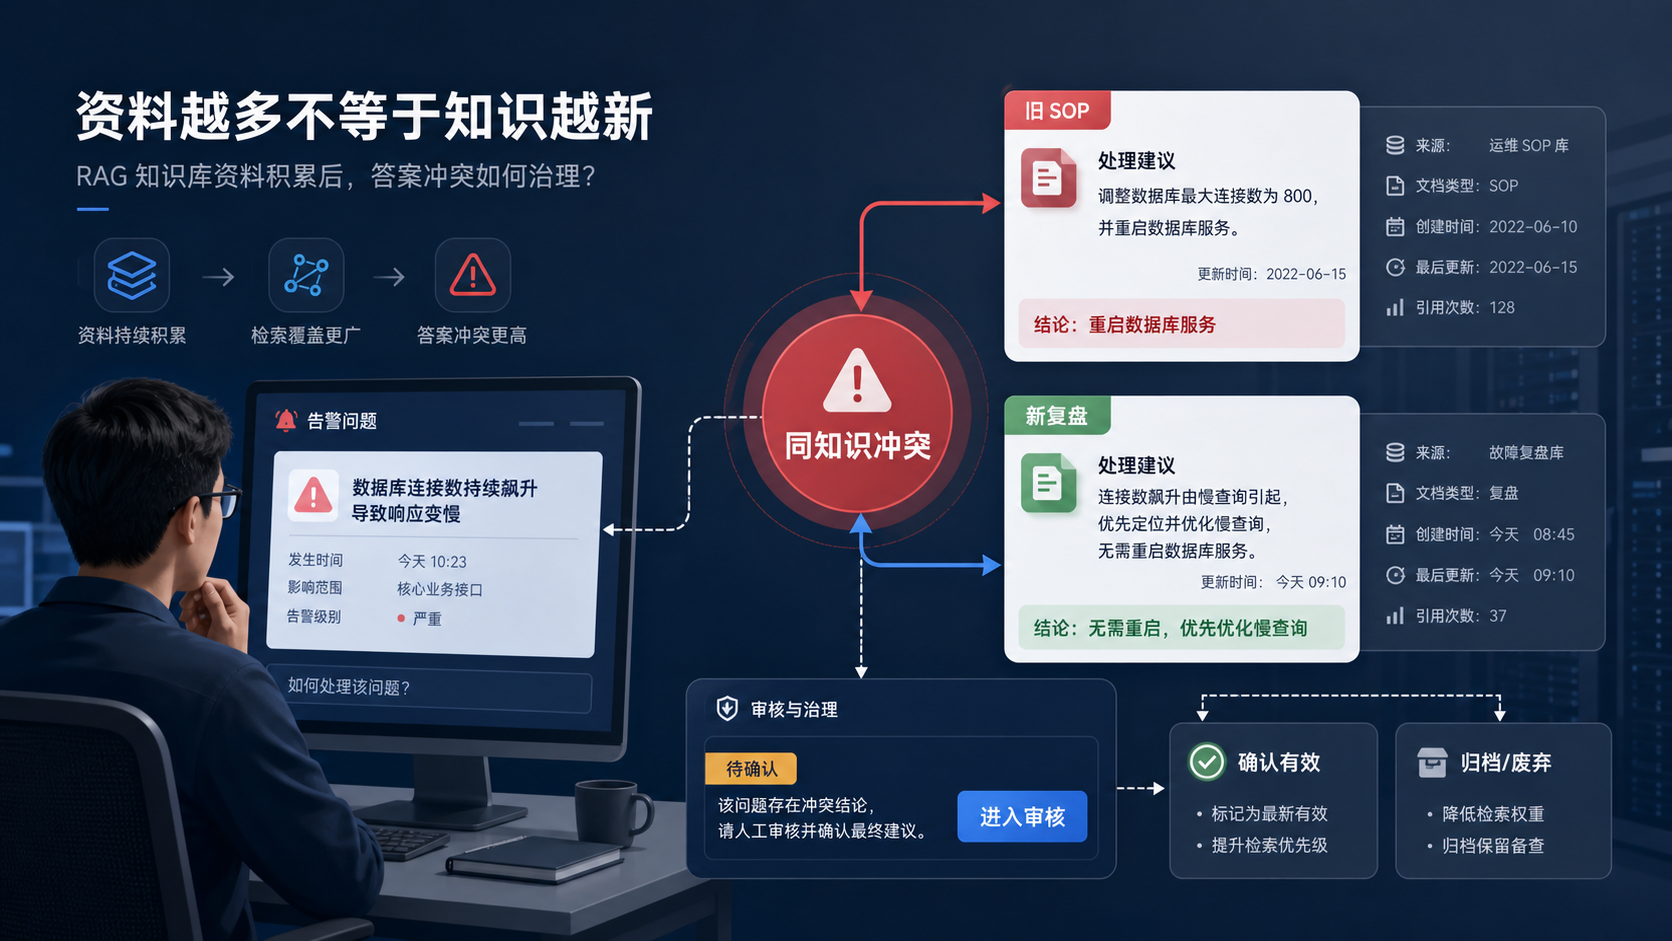
晨会前二十分钟,运维负责人小周被问到一个很具体的问题:昨晚数据库连接数飙高,今天再出现同样的告警,值班应该先重启服务,还是先隔离流量?

团队的知识库里很快找到了两段回答。三年前的运行手册写着“重启后观察”;上个月的故障复盘却记录“这类现象先限制流量,直接重启会扩大影响”。

两份材料都不是胡写的。前者对应早期架构,后者来自后续依赖关系变化后的处置经验。可当它们被同一次检索一起召回时,小周拿到的不是答案,而是两个都像答案的选择。

两份知识材料对同一告警给出冲突建议,等待进入审核治理

告警是自己恢复,还是被规则关掉?复盘时不能混成一种状态

· 阅读需 7 分钟

复盘从一句话卡住​

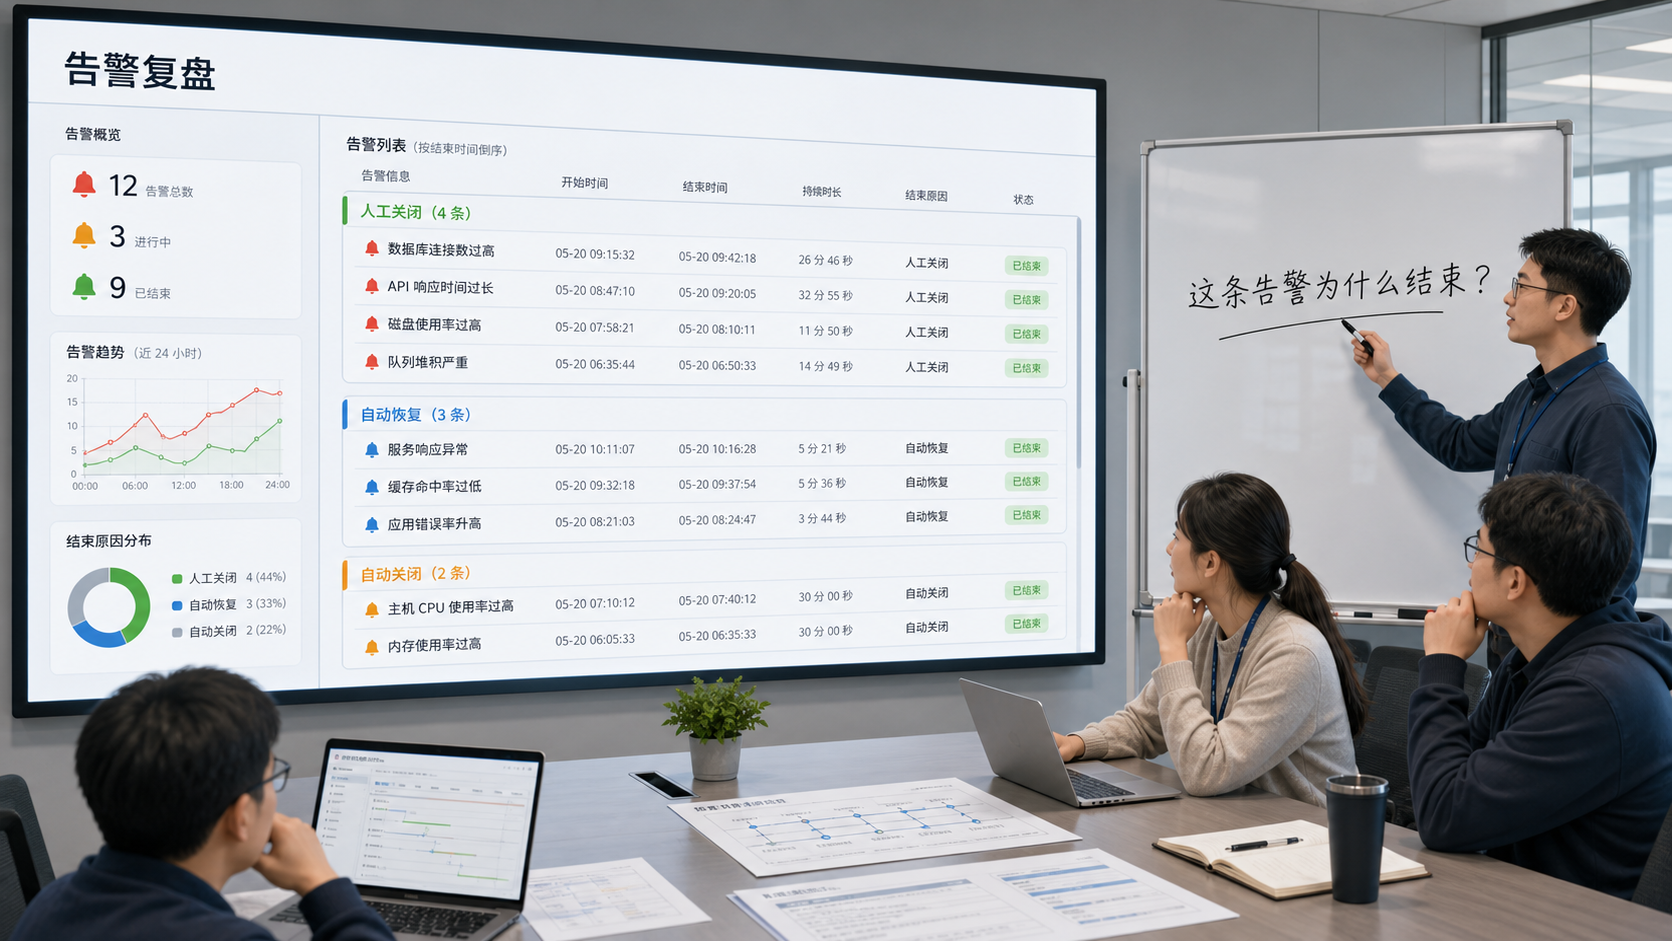
晨会前二十分钟,运维负责人小周被问到一个很具体的问题:昨天下午那批接口超时告警,到底是业务恢复了,还是规则自动关掉了?

他手里有告警列表,也有关闭率。列表上红点已经消失,几条告警都不再活跃。可继续往下追,现场开始卡住:有的告警是值班同学点了关闭,有的是恢复事件推回来的,还有几条是聚合告警过了不活跃时间后自动关闭的。

这时,“都结束了”反而变成最没有用的答案。

告警复盘真正要追的不是红点还在不在,而是它为什么离开了现场。

告警复盘现场中,团队正在区分人工关闭、自动恢复和自动关闭

等保要求下,密码策略如何守住身份入口

· 阅读需 8 分钟

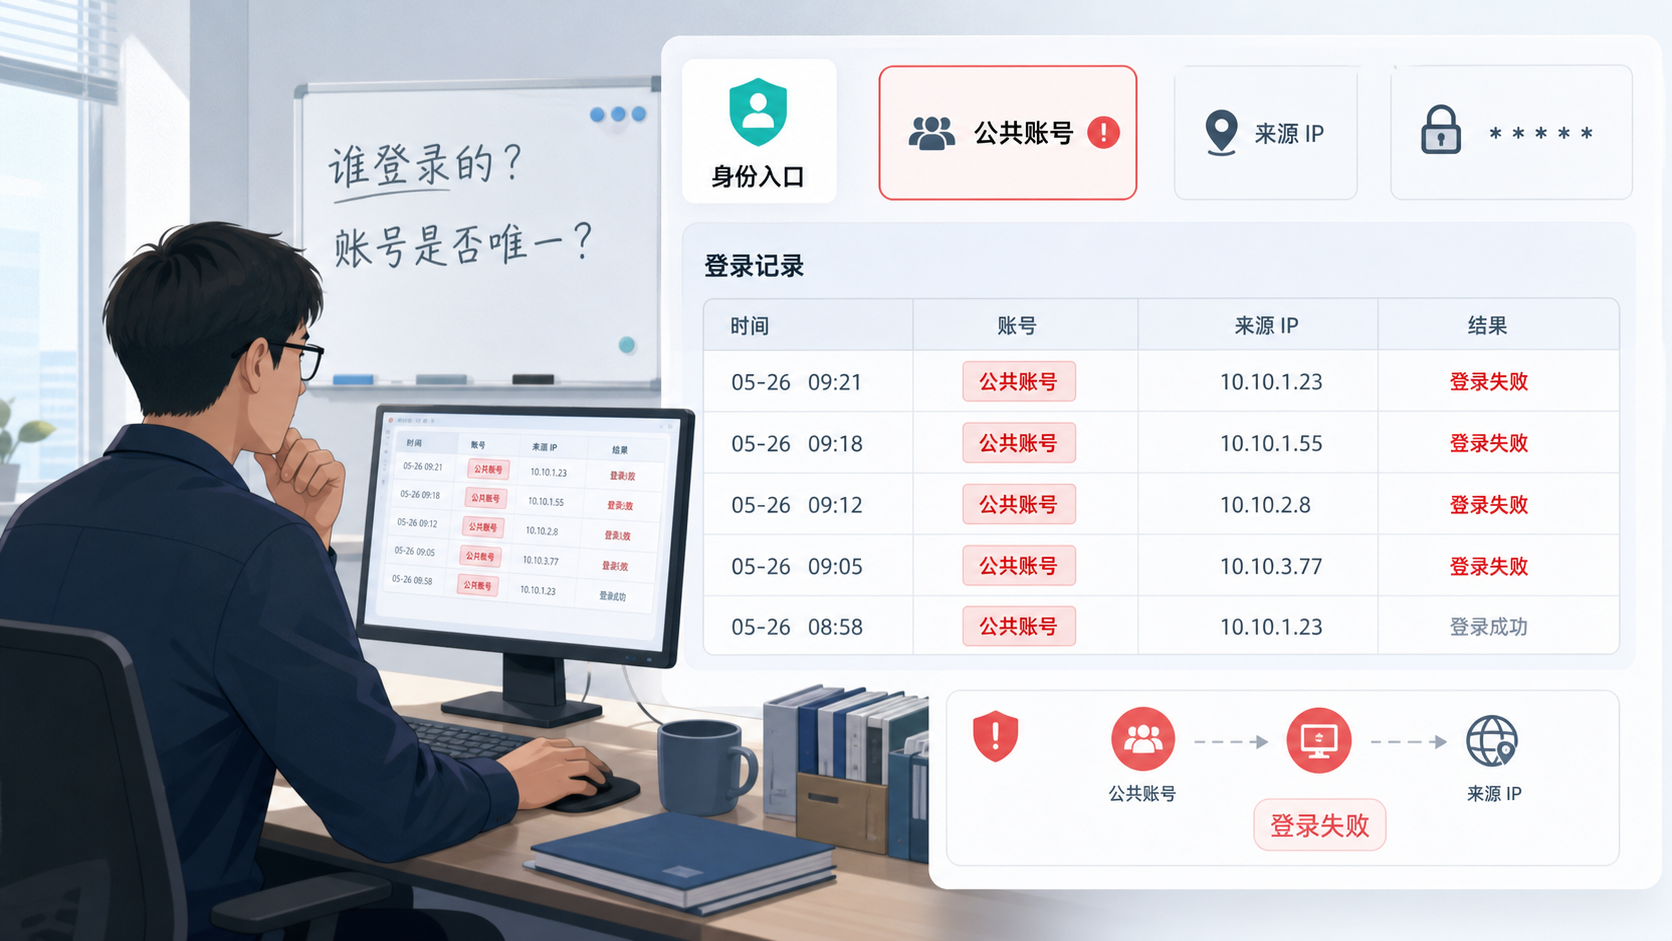
晨会前 20 分钟,运维负责人小李被问了一个很普通的问题:昨晚那次配置变更,到底是谁登录平台改的?

他打开审计记录,看到的是一个长期共用的运维账号。登录来源能查到,操作时间也能查到,但账号背后到底是哪位同事、哪家外包、哪次临时协助,没人敢马上下结论。

更麻烦的是,这个账号的密码已经很久没有换过。几个人都知道,浏览器里也可能保存过。复盘会还没开始,问题就已经从“谁改错了配置”,变成了“这个身份入口到底还能不能信”。

密码策略不是为了让登录页显得更安全,而是为了让账号、口令、会话和审计能连成一条可追溯的治理链。

共享账号和弱口令让身份入口失去追溯能力

K8s 集群 200 个 Pod,监控值班怎么「扫一眼」就定位异常

· 阅读需 7 分钟

一次上线后的故障响应​

上线当天的上午 10 点 40 分,业务接口人在群里发了一条消息:“用户反馈响应慢,你们看看是不是后端出问题了。”

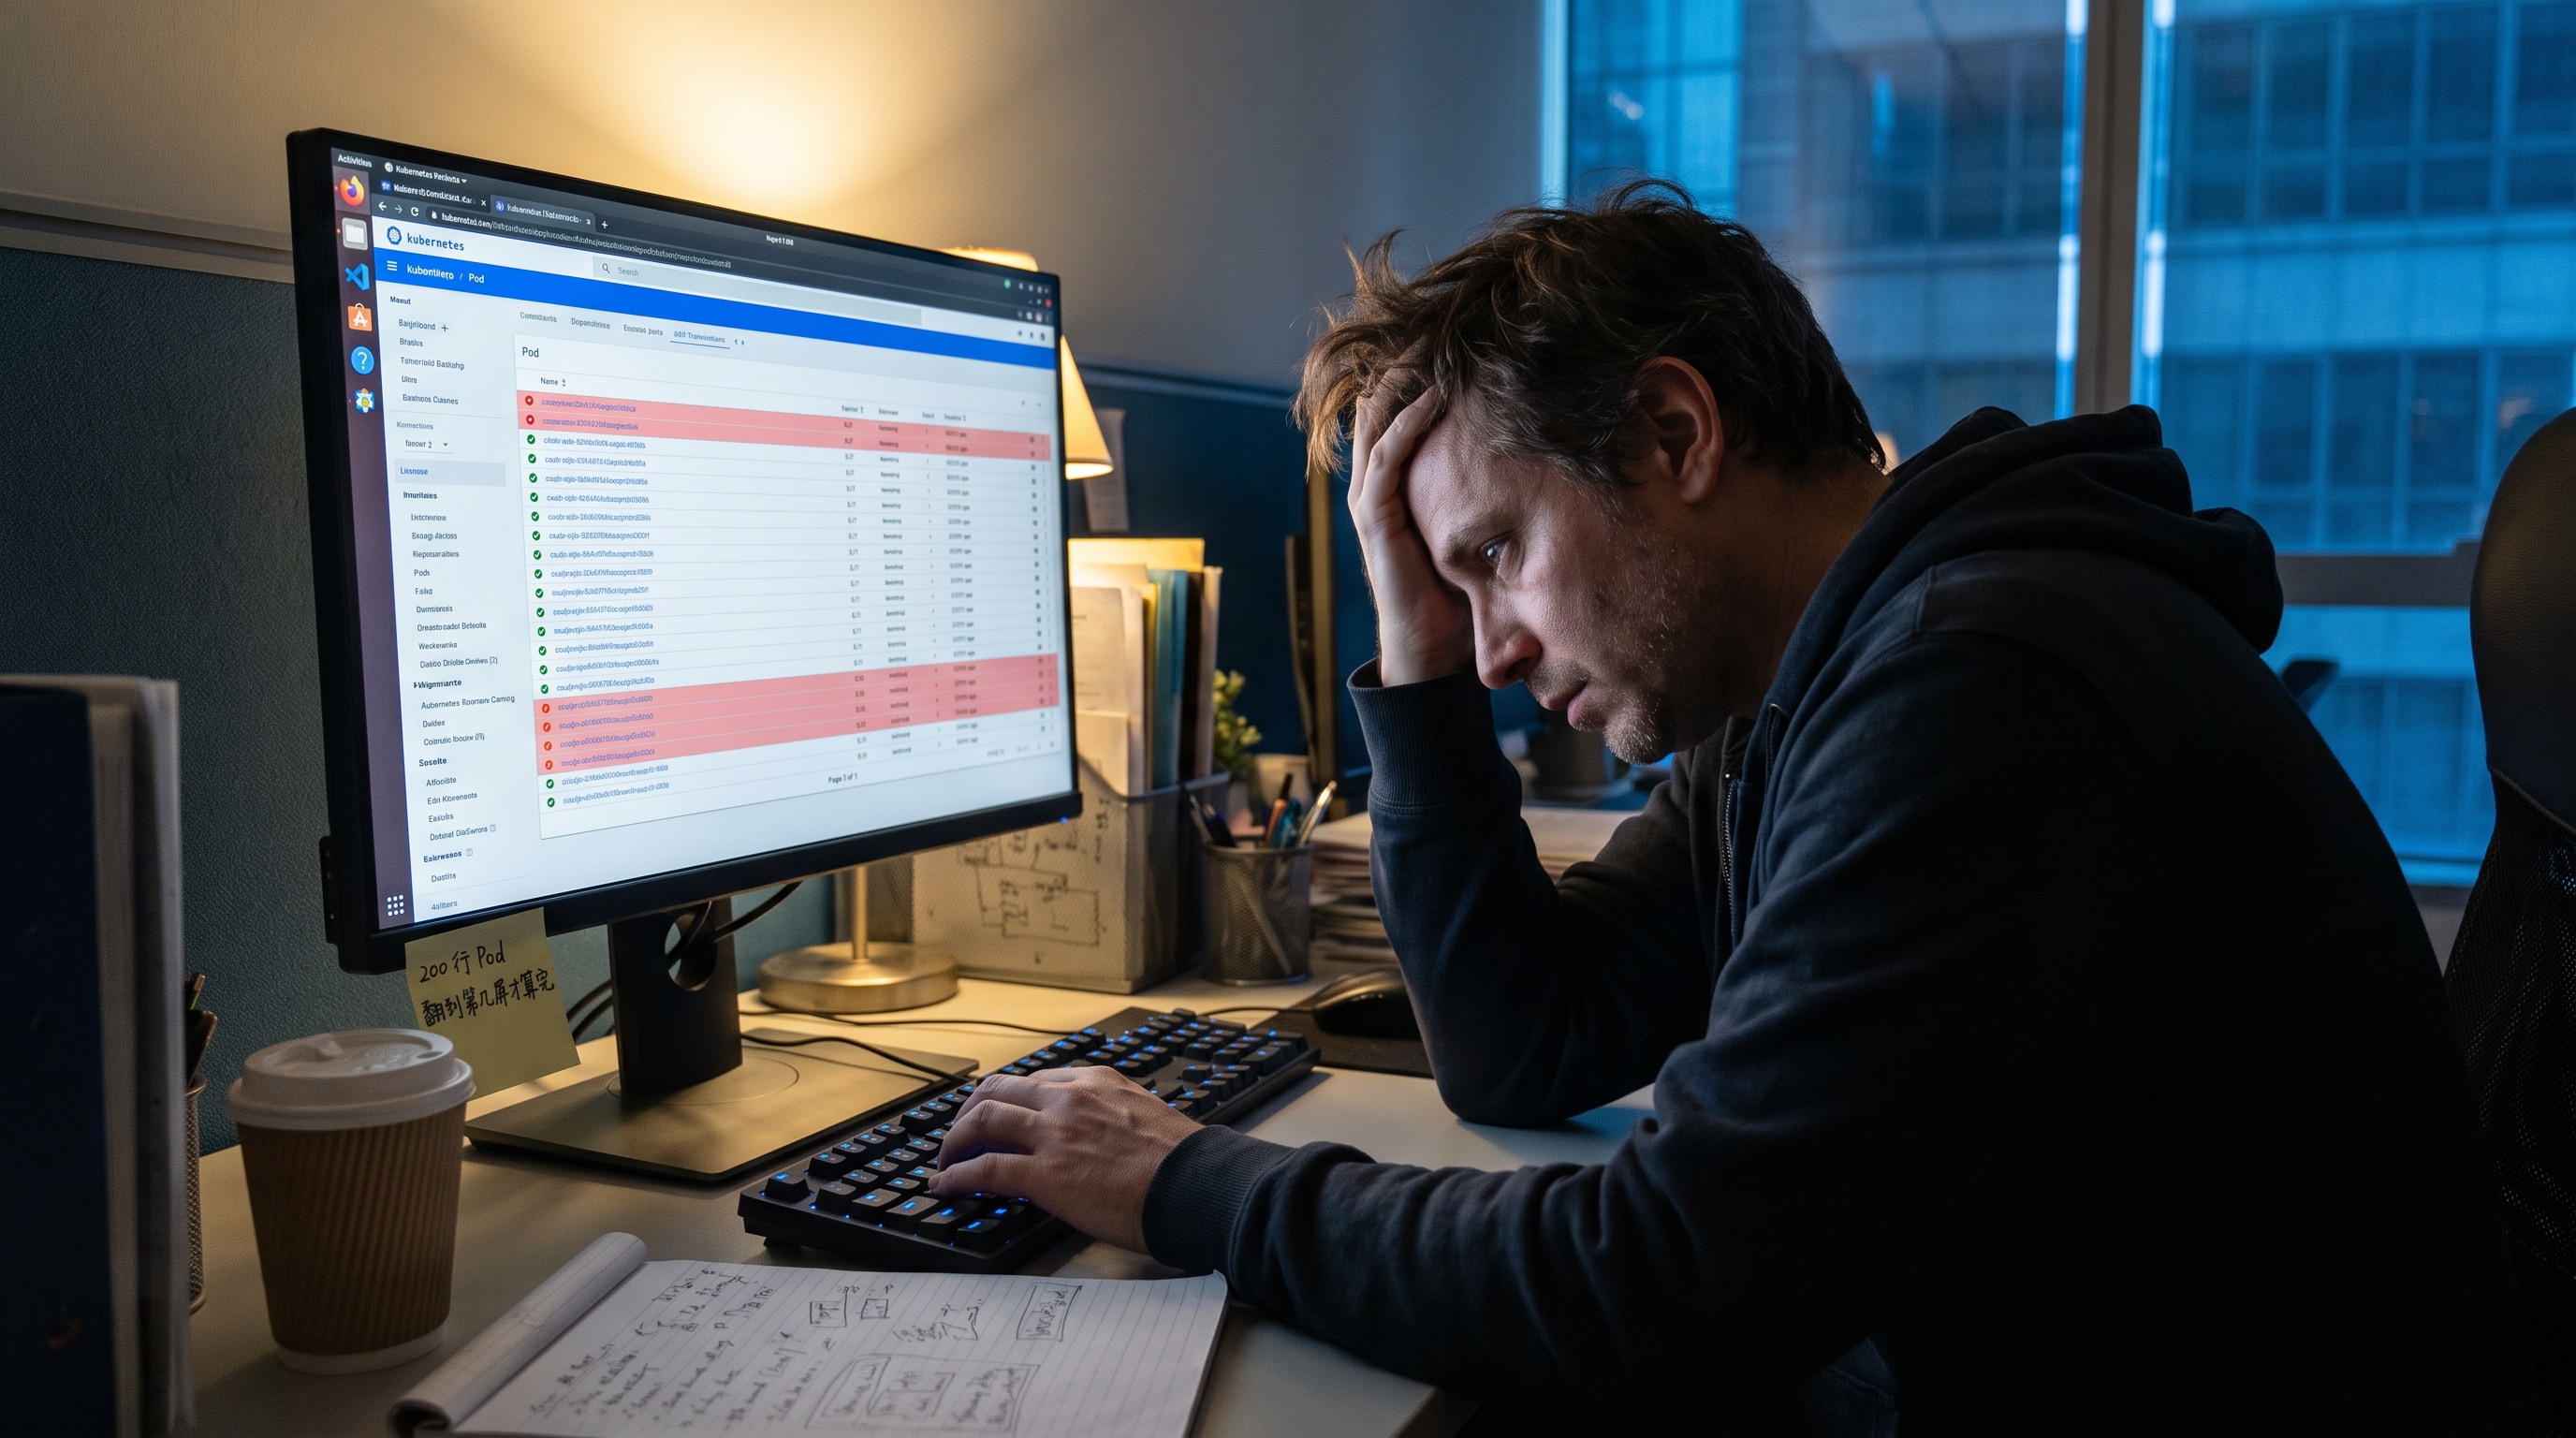
值班同学小周打开监控页面,看到的是 200 个 Pod 状态。

他想做的只有一件事:看哪几个不健康。

但这 200 行 Pod 状态,要滚 3 屏、4 屏、第 5 屏。他一直在做的不是排障,是“翻页找异常”。

群里开始有人追问“到底是哪个服务慢”。小周回到监控页,继续往下翻第 6 屏。

列表视图下 200 个 Pod 状态,值班翻屏找异常

翻到第 6 屏的时候,小周意识到,问题不是“列表不好用”,而是列表被错位用在了密度场景下。